Jak používat Claude Code pro práci s firemními a zákaznickými daty
Článek
12/10/2026
Jak používat Claude Code pro práci s firemními a zákaznickými daty
Práce s klientskými daty v Claude Code vyžaduje kontrolu nad jejich zpracováním. V článku popisujeme jak nastavit Claude Code přes Google Cloud, aby se klientská data zpracovávala v EU, pod DPA a bez trénování modelů.
Spousta freelancerů a agentur dnes používá Claude Code pro práci s daty, která nejsou veřejná. Ať už jsou to data o zákaznících zákazníků, podléhající GDPR, nebo data z webů, mediálních systémů a CRM klientů, která nemusí obsahovat přímo osobní údaje, ale jejich předání třetí straně je pod NDA. Nad těmito daty dělají analýzy, modely, dashboardy nebo je pomocí Claude zapojují do dalšího workflow. V tomto článku si ukážeme, jak s takovými daty pracovat v souladu s právními požadavky a mít kontrolu nad tím, kudy procházejí a kde se zpracovávají. A jak to využít i pro osobní potřebu, pokud chcete pomocí Claude zpracovávat nějaké osobní a citlivější věci.
U jakých dat je potřeba si dát pozor
Typicky jde o exporty z CRM a e-shopu (jména, e-maily, telefony, adresy, historie objednávek), seznamy kontaktů pro e-mailing, nebo publika nahrávaná do reklamních systémů.
Patří sem ale i data, která jako osobní údaje nevypadají: GA4 exporty s user ID nebo client ID, cookie identifikátory, IP adresy a logy ze serveru jsou podle GDPR pořád osobní údaje, protože je lze přiřadit ke konkrétnímu člověku.
Pozor si dejte také na texty od zákazníků, například tikety ze zákaznické podpory, přepisy chatů, odpovědi z dotazníků nebo recenze. Osobní a někdy i citlivé údaje (například o zdraví) se v nich mohou objevit nečekaně. Druhou skupinou jsou data bez osobních údajů, která ale kryje NDA: tržby, marže, výkon kampaní, ceníky nebo obchodní plány klienta.
Proč tato data nezpracovávat přes Claude Pro a Max
Většina uživatelů Claude a Claude Code jede na tarifech Pro a Max. Tyto tarify jsou ale spotřebitelské produkty a řídí se spotřebitelskými podmínkami. Z pohledu GDPR a možnosti s nimi zpracovávat klientská data je to problém. Pokud zpracováváte osobní údaje zákazníků svých klientů, potřebujete mít s každým dalším zpracovatelem uzavřenou zpracovatelskou smlouvu, tzv. DPA (Data Processing Addendum). Anthropic toto v rámci tarifu Pro a Max nenabízí.
Druhý problém je trénování modelů. Na tarifech Free, Pro a Max může Anthropic vaše konverzace i session z Claude Code použít k trénování nových modelů, pokud to máte v nastavení povolené. V takovém případě se navíc data uchovávají až pět let. Volbu sice můžete vypnout, je to ale přepínač v uživatelském účtu, ne smluvní závazek, o který se dá opřít před klientem.
Třetí věc je místo zpracování. Na spotřebitelských tarifech si nevyberete region, ve kterém se vaše data zpracovávají, a nemáte tak jak doložit, že neopustila EU. Anthropic tak může vaše data poslat na endpoint, který se nachází v USA, Asii nebo jinde. Stejná logika platí i pro data pod NDA, i když žádné osobní údaje neobsahují. Klientovi jste se zavázali, že je nepředáte třetí straně, a spotřebitelský účet vám k tomu nedává žádnou smluvní oporu.
Tarify Team a Enterprise sice nabízejí DPA, ani u nich si však nelze vybrat EU region pro zpracování dat. To může být pro některé větší klienty problém.
Pozor také na MCP servery, které pracují přímo s klientskými daty. I v tomto případě je potřeba řešit, přes jaký model se data zpracovávají. Pokud agentura rozjede MCP, které přímo něco dělá s osobními daty zákazníků klienta a jede na těchto tarifech, riskuje.
Jak tedy na to?
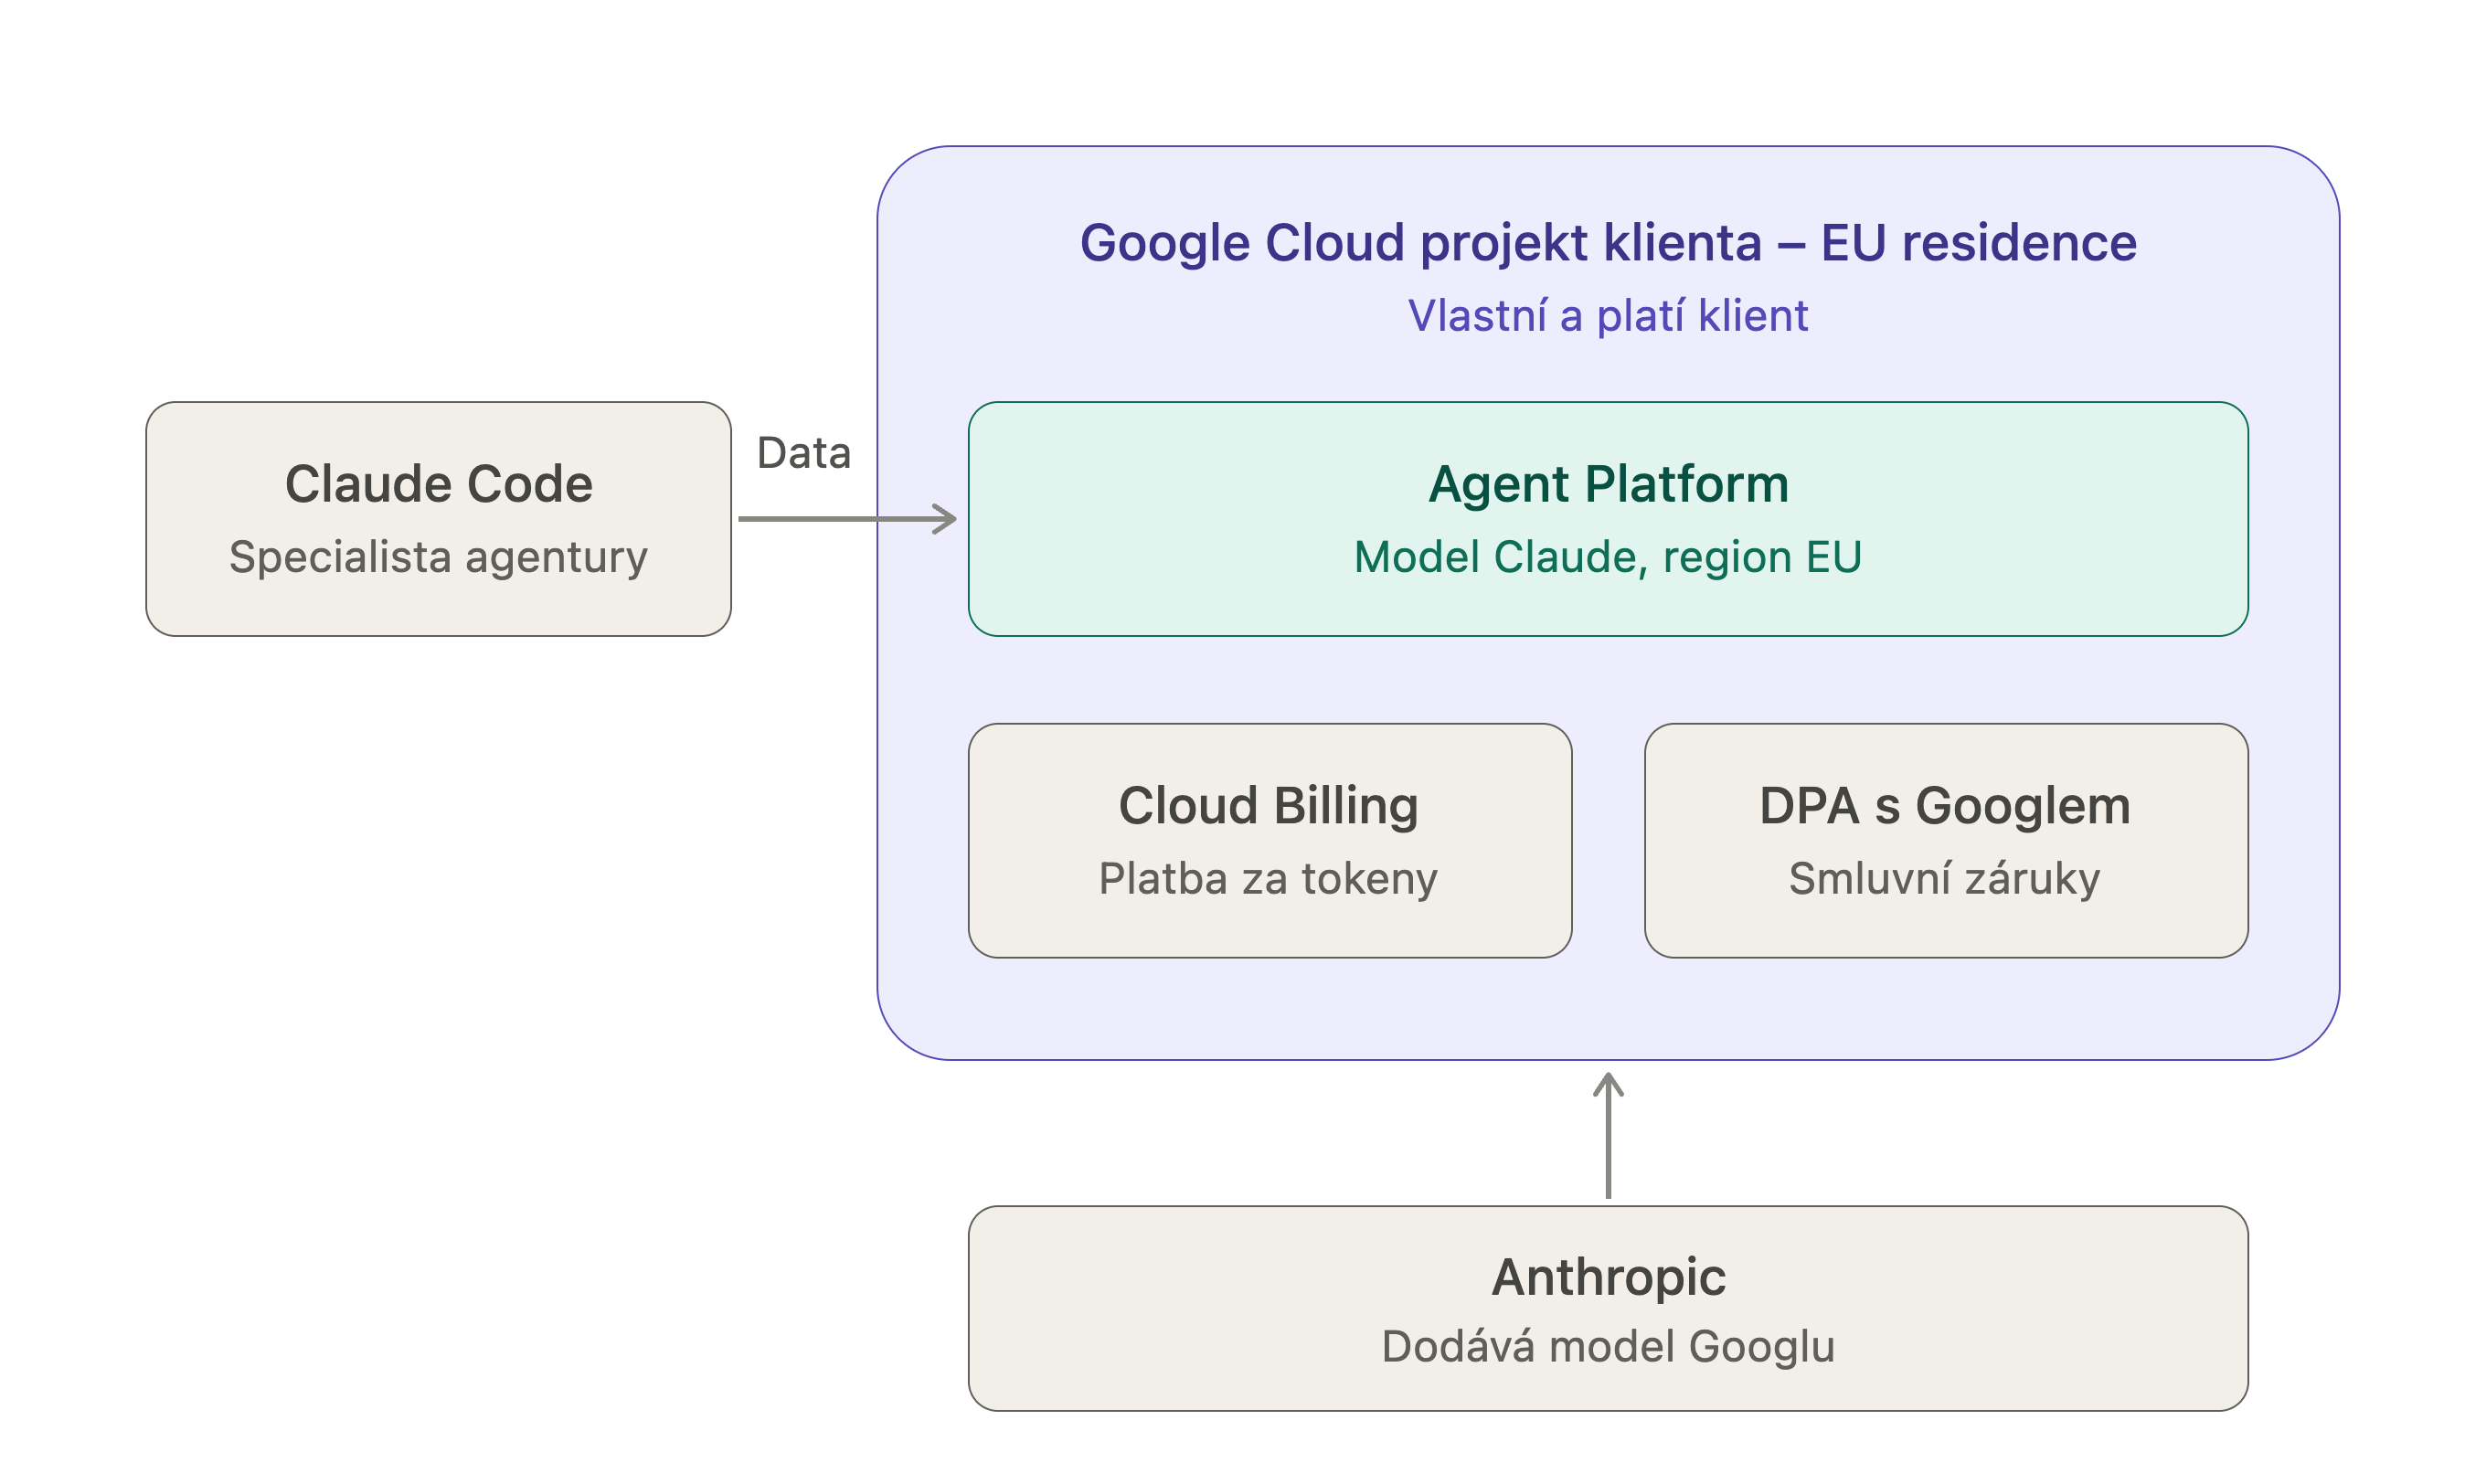
Řešením je používat Claude v režimu, kde tyto záruky máte. Za nás je ideální používat velké modely Anthropicu přes třetí stranu, která poskytuje DPA a garantuje zpracování dat v EU (tj. umožňuje výběr regionu, kde se s daty bude pracovat a kde budou zpracovávána). Námi preferovaná možnost je využít jako třetí stranu Google Cloud, který funguje jako “přeprodejce” celé řady velkých modelů (nejen od Anthropic) a umožňuje všechny garance, aby zpracování dat EU firem a jejich zákazníků bylo ok. Google má pro toto službu, která se jmenuje Agent Platform, v jejímž rámci si můžete aktivovat většinu posledních Claude modelů. A použít je nejen v nějaké Google Cloud aplikaci nebo workflow, ale i v Claude Code. V kontextu tohoto článku se zaměříme hlavně na nastavení pro práci s Claude Code, do kterého jdou napojit modely Anthropicu kupované přes Agent Platform (na výběr jsou všechny aktuální modely).
Kouzlo je v tom, že freelancer nebo agenturní specialista sice pracuje s daty klienta pomocí Claude Code, ale v konfiguraci používá model, který je „zapnutý“ v konkrétním Google Cloud projektu klienta. Tj. specialista vlastně jen „obsluhuje“ data klienta nástrojem klienta, protože správně nastavený Google Cloud projekt vlastní klient a ne agentura. Zároveň specialista může přepínat konfiguraci na jiné klientské Google Cloud projekty, pokud potřebuje jeden den pracovat s daty klienta A a druhý den s daty klienta B.
V článku ukážeme potřebné nastavení, výběr modelu a tři možnosti konfigurace, od jednorázové session až po globální nastavení. Zaměříme se také na regiony, práci s citlivými soubory a nastavení budgetu.
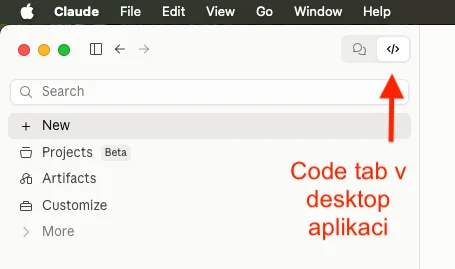
Celý postup se týká Claude Code, tedy nástroje v terminálu (případně Code tabu v desktopové aplikaci). Běžný chat na claude.ai, v desktopové ani mobilní aplikaci se na Agent Platform přepnout nedá a vždy běží pod vaším účtem u Anthropicu, tedy za podmínek popsaných výše. Pokud tedy klientská nebo citlivá data vložíte do chatu v aplikaci, žádné z těchto záruk neplatí.
Nastavení Claude Code s modelem kupovaným přes Google Agent Platform
Agent Platform je novější označení služby, kterou Google dříve označoval jako Vertex AI. V dokumentaci proto můžeme narazit na obě označení. Pro účely tohoto článku budeme používat jednotně název Agent Platform.
PreREkvizity
Než se pustíme do konfigurace, potřebujeme mít připravených několik věcí:
Google Cloud účet s povoleným billingem
Nainstalované Google Cloud SDK (gcloud)
Nainstalovaný Claude Code
Povolené Agent Platform API
API můžeme povolit v API Library nebo pomocí příkazu:
gcloud services enable aiplatform.googleapis.com
Jakmile máme základní nastavení hotové, můžeme se pustit do výběru modelu.
Výběr a povolení modelu
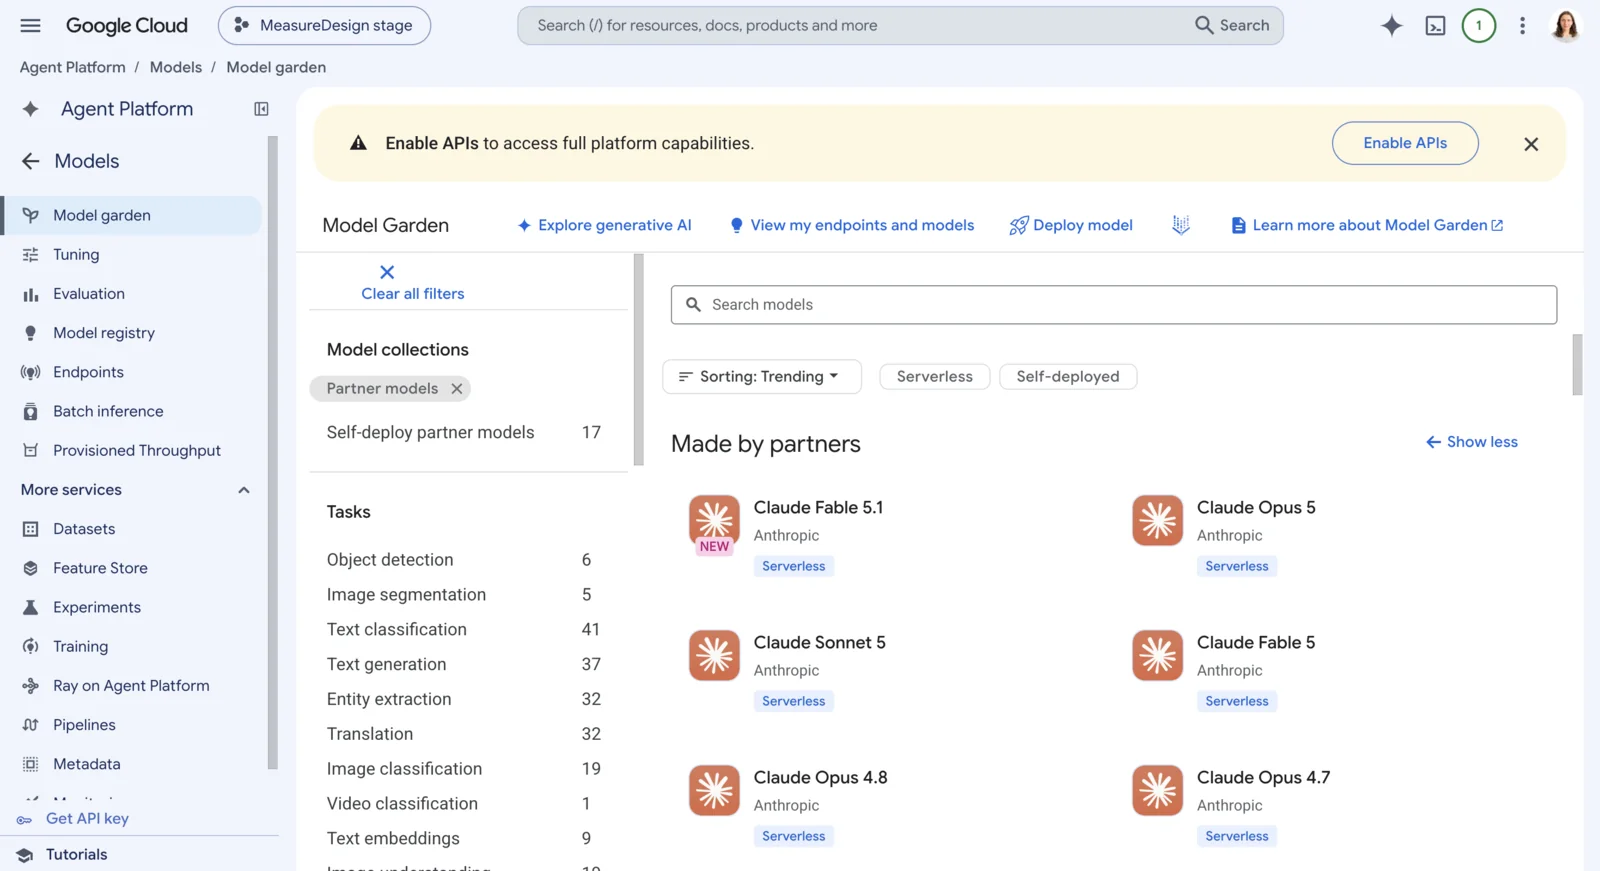
Model vybíráme podle toho, k čemu ho chceme používat. U jednoduchých úkolů například nedává smysl používat zbytečně drahý model. Zároveň si předem ověříme jeho dostupnost a cenu. Přehled dostupných modelů a jejich ceník najdeme v Google Cloud v Model Garden v našem projektu.
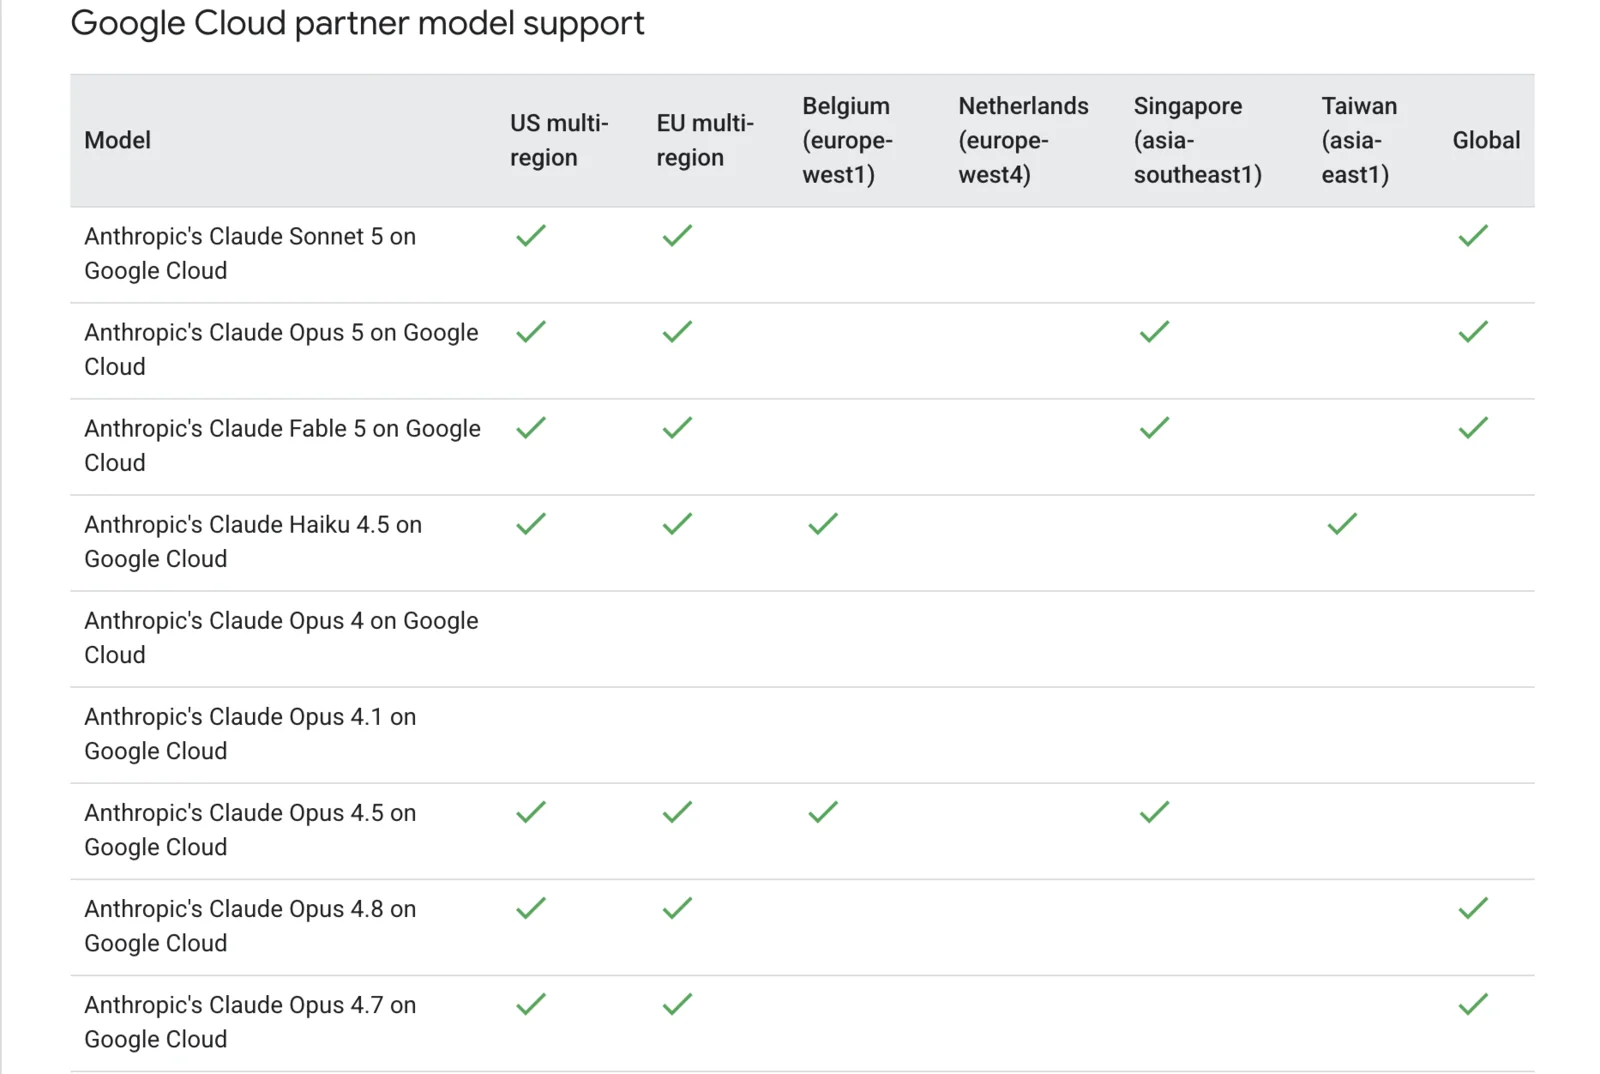
Při výběru modelu si musíme dát pozor také na podporovaný region. Některé modely jsou dostupné v single regionu, jiné podporují multi region a některé obě varianty.
Rozdíl je v tom, kde může zpracování probíhat. Při použití single regionu můžeme například nastavit Belgii a data se pak zpracovávají pouze v tomto regionu. U evropského multi regionu se mohou data zpracovávat kdekoliv v EU. Multi region zároveň bývá rychlejší. Dostupnost jednotlivých modelů v regionech si můžeme ověřit v dokumentaci Google.
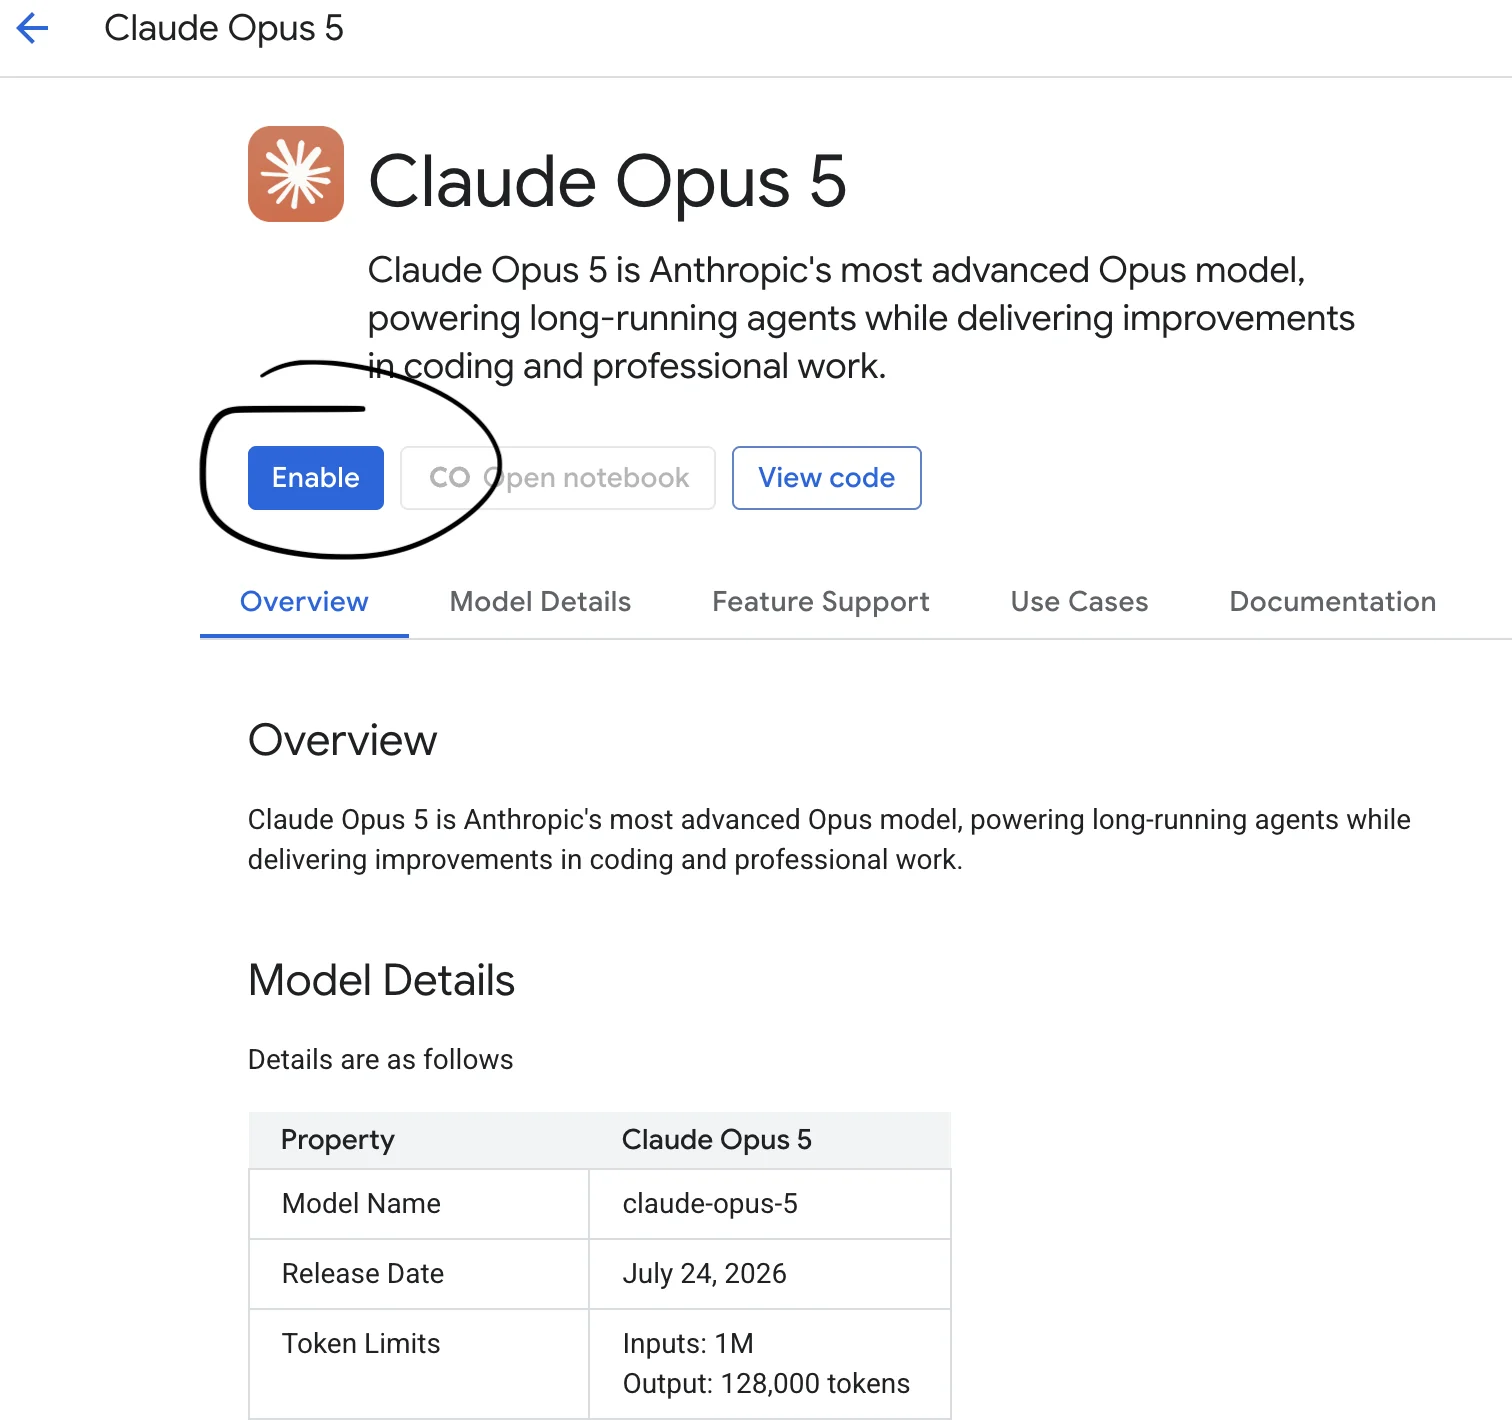
Jakmile máme vybraný model a ověřený požadovaný region, povolíme model v Model Garden. Na kartě konkrétního modelu stačí kliknout na „Enable“.
Nastavení prostředí
Po povolení modelu se můžeme pustit do konfigurace Claude. Nejdřív si potřebujeme říct, jak chceme Agent Platform používat. Máme tři možnosti.
1. Použití jen pro konkrétní session
Nejrychlejší možností je nastavit Agent Platform pouze pro jednu konkrétní session. Stačí ji spustit příkazem, ve kterém zadáme jméno projektu a model:
CLAUDE_CODE_USE_VERTEX=1 \
CLOUD_ML_REGION=eu \
ANTHROPIC_VERTEX_PROJECT_ID=PROJECT_ID \
claude --model claude-sonnet-5
Příkaz je potřeba upravit podle našeho projektu a zvoleného modelu.
Důležité je správně zkombinovat model a region. Ne každý model podporuje každý region a při použití špatné kombinace může Claude skončit chybou 429.
Tato varianta se hodí hlavně pro rychlé vyzkoušení. Nastavení se použije pouze při spuštění dané session a nijak nemění naše ostatní projekty.
2. Používání v konkrétní složce (doporučené)
Pro běžnou práci doporučujeme nastavení na úrovni konkrétní projektové složky. Máme tak kontrolu nad tím, kde Claude používá Agent Platform, a konfigurace nám nezasáhne do ostatních projektů. Tj. například si uděláme složku pro klienta A, kde používáme model kupovaný z jeho Google Cloud projektu. Pokud potřebujeme pracovat s daty jiného klienta (klient B), v jeho projektové složce si konfiguraci přepneme na model kupovaný přes jeho Google Cloud projekt.
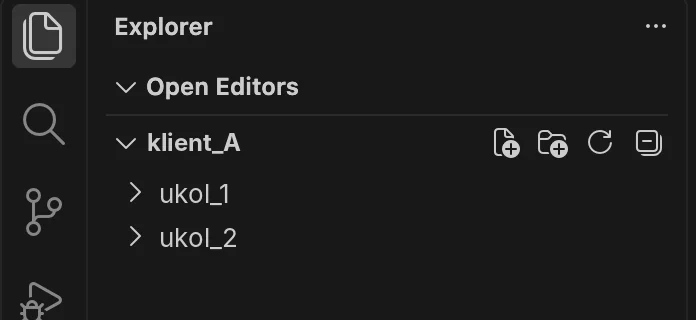
Pro představu si ukážeme situaci, kdy chceme Agent Platform používat pro všechny úkoly nad daty klienta ve složce klient_A.
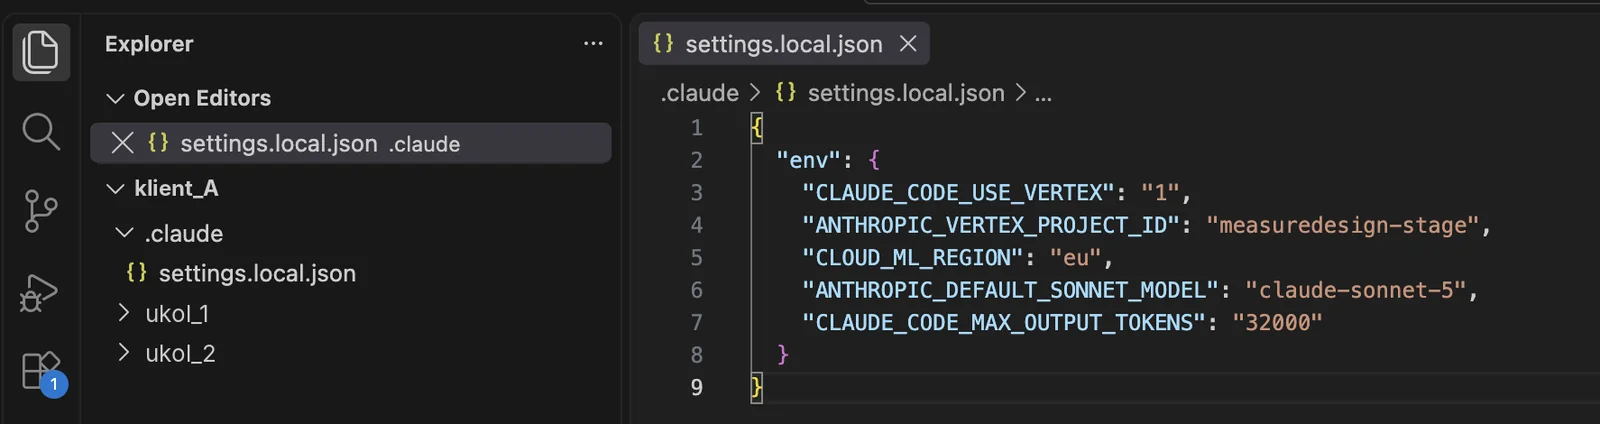
Do složky klient_A přidáme složku .claude, ve které budeme mít konfiguraci. V ní vytvoříme soubor settings.local.json a vložíme potřebné nastavení.
V základním nastavení je pouze malá část proměnných, které můžeme nastavit. Kompletní seznam najdeme v dokumentaci Claude. Jde například o velikost kontextového okna nebo maximální počet output tokenů.
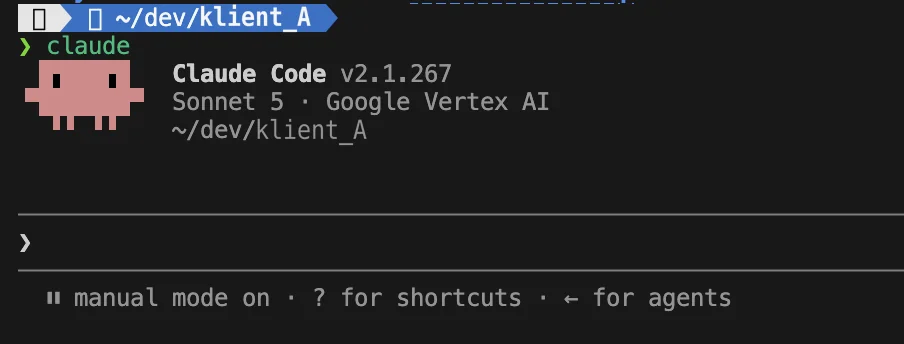
Claude pak spustíme v terminálu pomocí příkazu claude a ověříme, že se použilo nastavení přes Agent Platform.
Tato varianta je podle nás nejlepší kompromis mezi pohodlím a kontrolou. Agent Platform používáme pouze tam, kde ho opravdu chceme, a zároveň nemusíme měnit globální nastavení počítače.
3. Používání globálně
Poslední možností je globální nastavení. V tomto případě se konfigurace Agent Platform nastaví automaticky i v Claude Desktop aplikaci, konkrétně v Code tabu (ne v konverzačním tabu!).
Tady je ale potřeba zpozornět. Zpracování sice proběhne v EU, ale nepodařilo se nám ověřit, zda se následná konverzace neloguje nebo neukládá na serverech mimo EU. Safe varianta je tedy použití přes Claude Code.
Pokud chceme Agent Platform používat pro všechny projekty (například pokud freelancer dělá jen pro jednoho klienta a nepoužívá Claude na daném počítači pro osobní věci), může být globální nastavení vhodnou variantou.
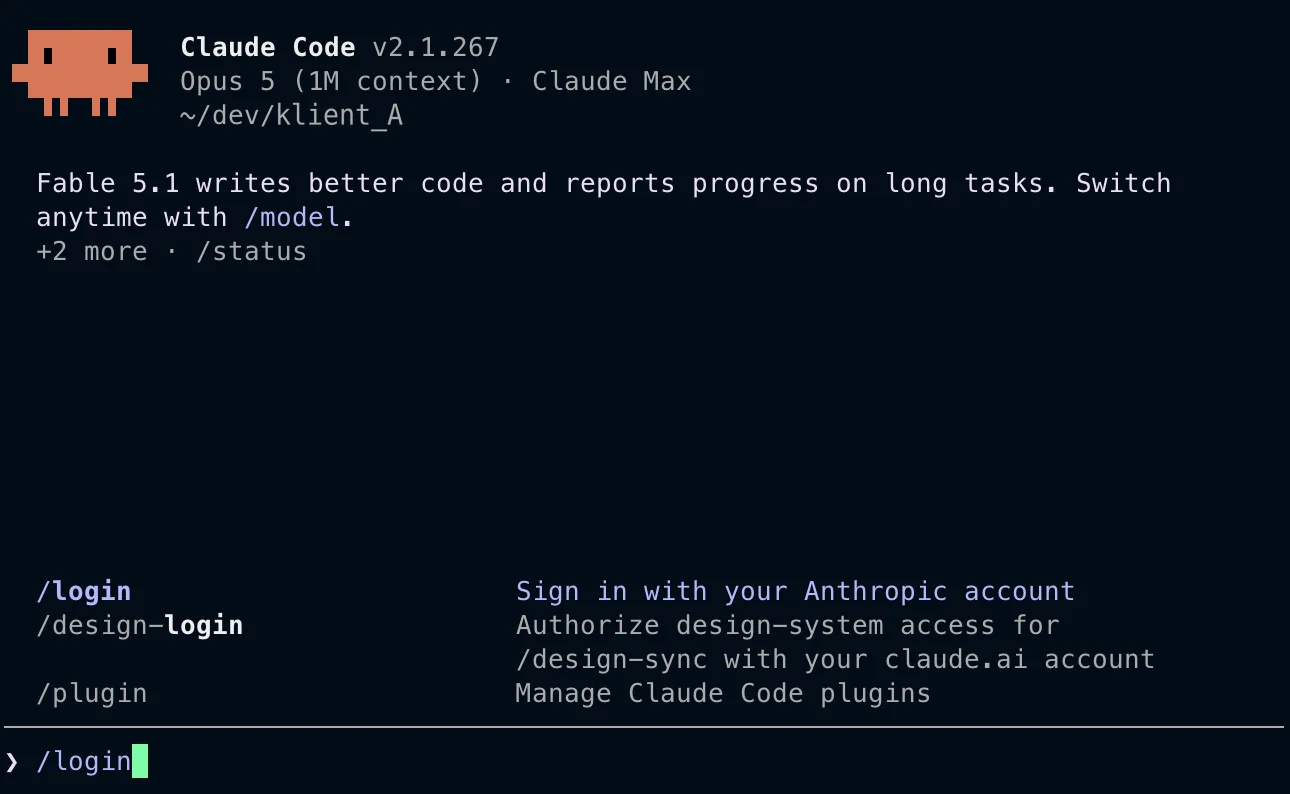
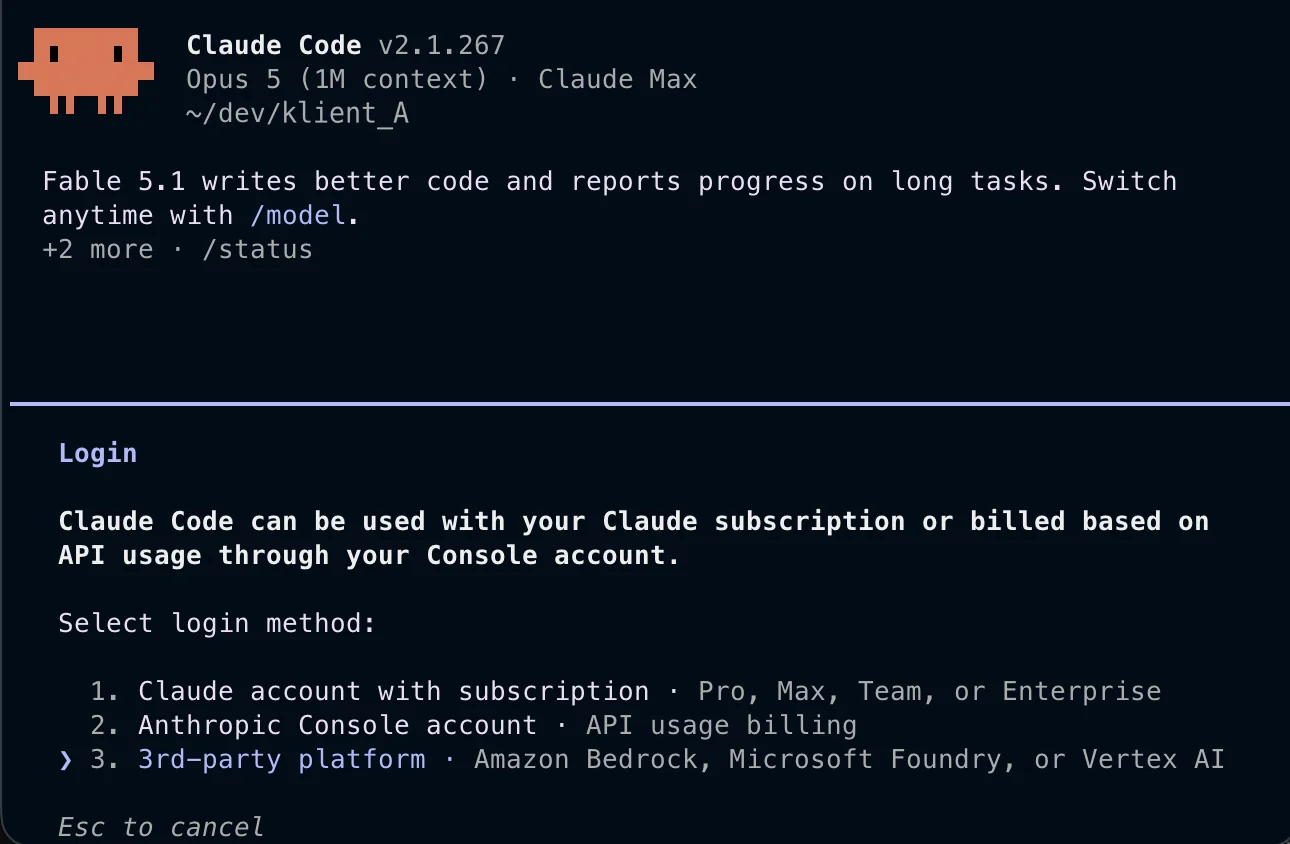
Globální konfiguraci nastavíme přímo z Claude pomocí příkazu /login.
Průvodce je intuitivní a stačí postupovat krok za krokem. Vybereme, že chceme Claude používat přes Agent Platform, nastavíme region pro zpracování dat, Google Cloud projekt, způsob přihlášení a další parametry.
Nastavení si potom můžeme prohlédnout a upravit podobně jako u druhé varianty. Globální konfigurace je uložená v souboru: /Users/user/.claude/settings.json
TIP: Na Macu je složka .claude skrytá. Odkryjeme ji pomocí klávesové zkratky Command + Shift + .
Sledování nákladů na model
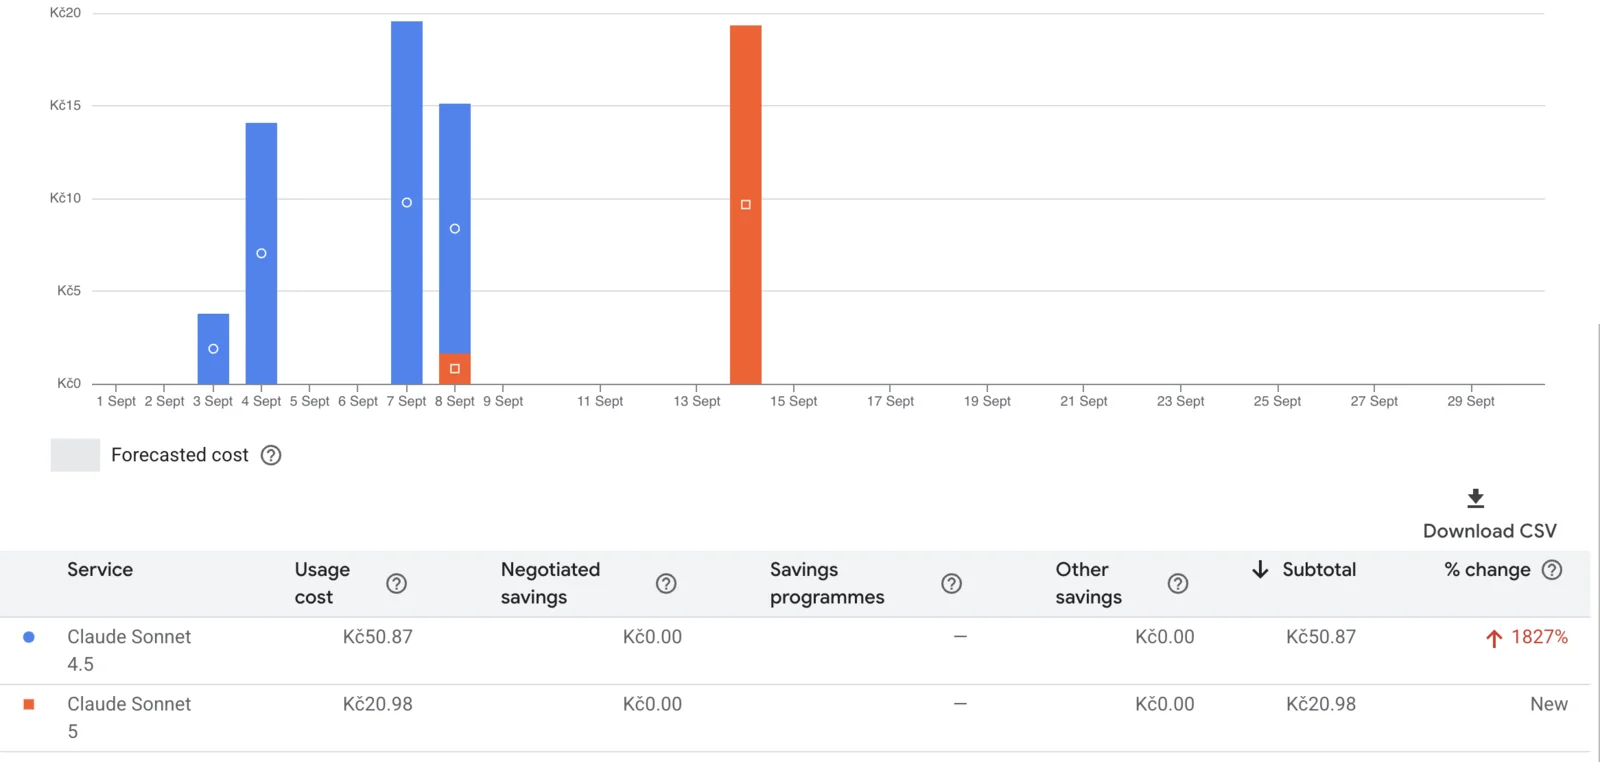
Při používání modelů přes Agent Platform je dobré průběžně sledovat také náklady. Náklady na model se totiž účtují prostřednictvím Google Cloud Billingu, nikoliv v rámci předplatného Claude Pro nebo Max. V Google Cloud Billingu si můžeme zobrazit, kolik za jednotlivé modely denně utrácíme. Spendy můžeme filtrovat podle konkrétního modelu, takže máme přehled o tom, kolik nás používání jednotlivých modelů skutečně stojí.
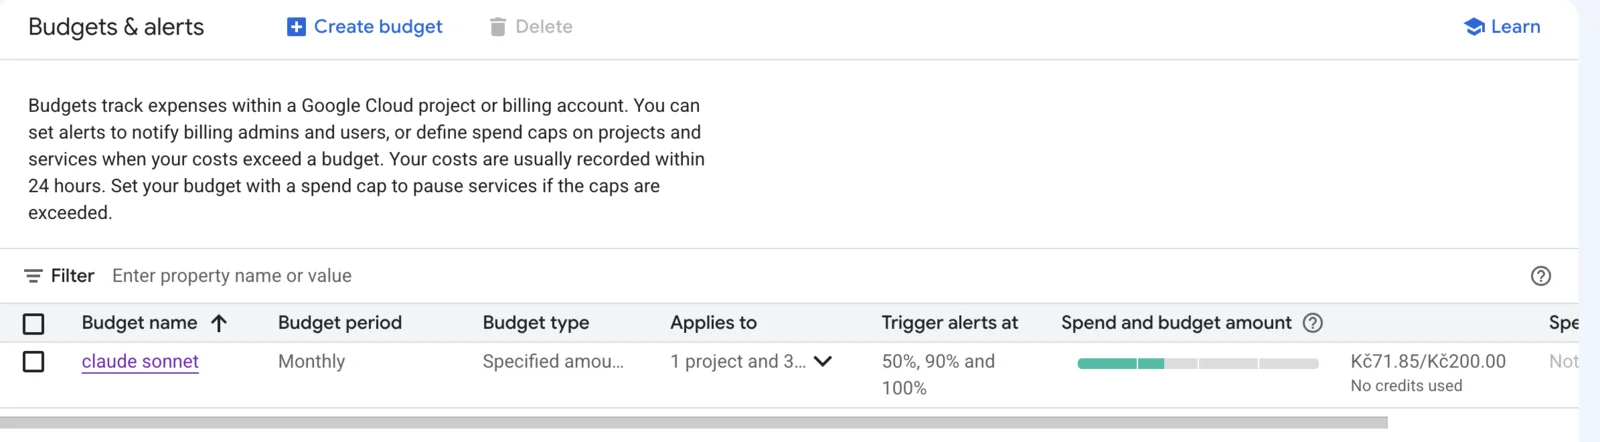
Kromě samotného přehledu nákladů si můžeme nastavit také budget a upozornění. Najdeme je v Billing → Budgets & Alerts. Nastavíme si částku, kterou chceme na používání modelů vyčlenit, a můžeme si určit i jednotlivé hladiny, při kterých nás Google Cloud upozorní.
Například si nastavíme budget 200 Kč a upozornění při dosažení 50 %, 90 % a 100 % rozpočtu. Jakmile se některou z nastavených hranic dostaneme, přijde nám e-mailové upozornění.
Je ale důležité počítat se zpožděním. Google Cloud uvádí, že zobrazení nákladů v Billingu může trvat až 24 hodin. Alert proto nemusí přijít ve chvíli, kdy skutečně danou částku utratíme. Teoreticky tak můžeme například v pondělí výrazně navýšit spend, ale o překročení nastavené hranice se dozvědět až v úterý.
Budget proto nevnímáme jako pevný limit ani jako ochranu před okamžitým překročením nákladů. Slouží především jako nástroj pro monitoring a upozornění.
V Google Cloudu existují i další způsoby, jak kontrolovat náklady a například odpojit model při překročení nákladových limitů. Je to už ale složitější téma a zkusíme se mu věnovat v některém z dalších článků.
Ochrana citlivých souborů
Ať už zvolíme kteroukoliv variantu konfigurace, Claude typicky spouštíme uvnitř konkrétní projektové složky. Standardně tak může pracovat se soubory, které jsou v projektu uložené. Mezi ně může patřit například .env s API klíči, tokeny nebo hesly.
To je potřeba ošetřit explicitně, protože výchozí nastavení čtení těchto souborů nezablokuje.
Do settings.local.json nebo do sdíleného .claude/settings.json proto můžeme přidat sekci permissions.deny:
Toto doporučení platí bez ohledu na to, kterou ze tří variant konfigurace zvolíme. Pokud Claude spouštíme uvnitř projektu, měli bychom si vždy rozmyslet, ke kterým souborům mu chceme umožnit přístup.
Využití pro osobní citlivé věci (Vašek)
Výše uvedený postup se dá použít i pro věci, které jsou osobní a nechcete je pouštět do světa úplně nekontrolovaně, ale do modelu, který je v EU a který se na datech neučí. Je to možná trochu paranoia, ale když chci s Claude řešit nějaké osobnější věci, používám Claude Code aktivovaný přes svůj osobní Google Cloud projekt, který si platím. Patří sem například témata týkající se zdraví, financí nebo právních záležitostí. Veškeré odpovědi je samozřejmě potřeba brát s rezervou. :)
Závěrečné shrnutí
Používání Claude přes Agent Platform nám umožňuje kombinovat Claude s kontrolou nad regionem, ve kterém se model zpracovává. Základem je správně zvolit model a region. Ne každý model je dostupný ve všech regionech a ne každý podporuje multi region.
Pokud nám záleží na tom, aby data zůstala v jedné konkrétní zemi, například v Belgii, zvolíme single region. Pokud nám stačí zpracování kdekoliv v EU, můžeme využít evropský multi region. Správnou kombinaci modelu a regionu si vždy ověříme předem.
Stejně tak je dobré mít pod kontrolou náklady. V Google Cloud Billingu můžeme sledovat spendy podle jednotlivých modelů a pomocí Budgets & Alerts si nastavit rozpočet i upozornění při jeho postupném čerpání.
Pro běžnou práci doporučujeme nastavení v konkrétní projektové složce. Je to nejlepší kompromis mezi pohodlím a kontrolou. Agent Platform se použije pouze tam, kde ho opravdu chceme, a zároveň nezasáhne do ostatních projektů.
Jednorázová session se hodí pro rychlé vyzkoušení. Globální nastavení pak dává smysl hlavně v případě, kdy Claude Desktop nepoužíváme a chceme Agent Platform používat jako výchozí variantu pro všechny projekty.
Nejdůležitější pravidlo ale zůstává stejné bez ohledu na konfiguraci: posílejme modelu jen to, co je nezbytně nutné. To, že zpracování probíhá v EU, neznamená, že bychom do modelu měli posílat všechno. Například vyloženě osobní data (e-maily, telefony apod.) je vždy lepší anonymizovat.
Claude se často spouští přímo uvnitř projektové složky a standardně tak může pracovat například s .env, klíči nebo dalšími citlivými soubory. Proto doporučujeme přístup k těmto souborům explicitně omezit pomocí permissions.deny.
Doufáme, že vám tento návod ušetří čas při rozjezdu a eliminuje rizika při nesprávném použití této technologie.
Kdo stojí za článkem
Martina Kvasničková
AI & Data Research
Marťa v MeasureDesign zkoumá velké jazykové modely a hledá praktické způsoby, jak AI zapojit do každodenní práce celého týmu.
Práce s klientskými daty v Claude Code vyžaduje kontrolu nad jejich zpracováním. V článku popisujeme jak nastavit Claude Code přes Google Cloud, aby se klientská data zpracovávala v EU, pod DPA a bez trénování modelů.
Google Ads patří mezi nejjednodušší zdroje pro napojení do BigQuery. Ukážeme si nastavení DTS konektoru, volbu mezi Standard a Custom reports, práci se service accountem, MCC strukturou, PMax tabulkami i časté limity.
Založit Google Cloud projekt zabere pár minut. Některé důležité věci ale základní návody neřeší. Ukážeme, co si pohlídat u vlastnictví projektu, trial verze a billing rolí, abyste se později vyhnuli zbytečným problémům.
Na letošním MeasureCamp Czechia jsme za MeasureDesign měli tři přednášky. Mluvili jsme o AI analytice nad firemními daty, identifikaci bot trafficu i o tom, jak skloubit práci v analytice s péčí o malé děti.
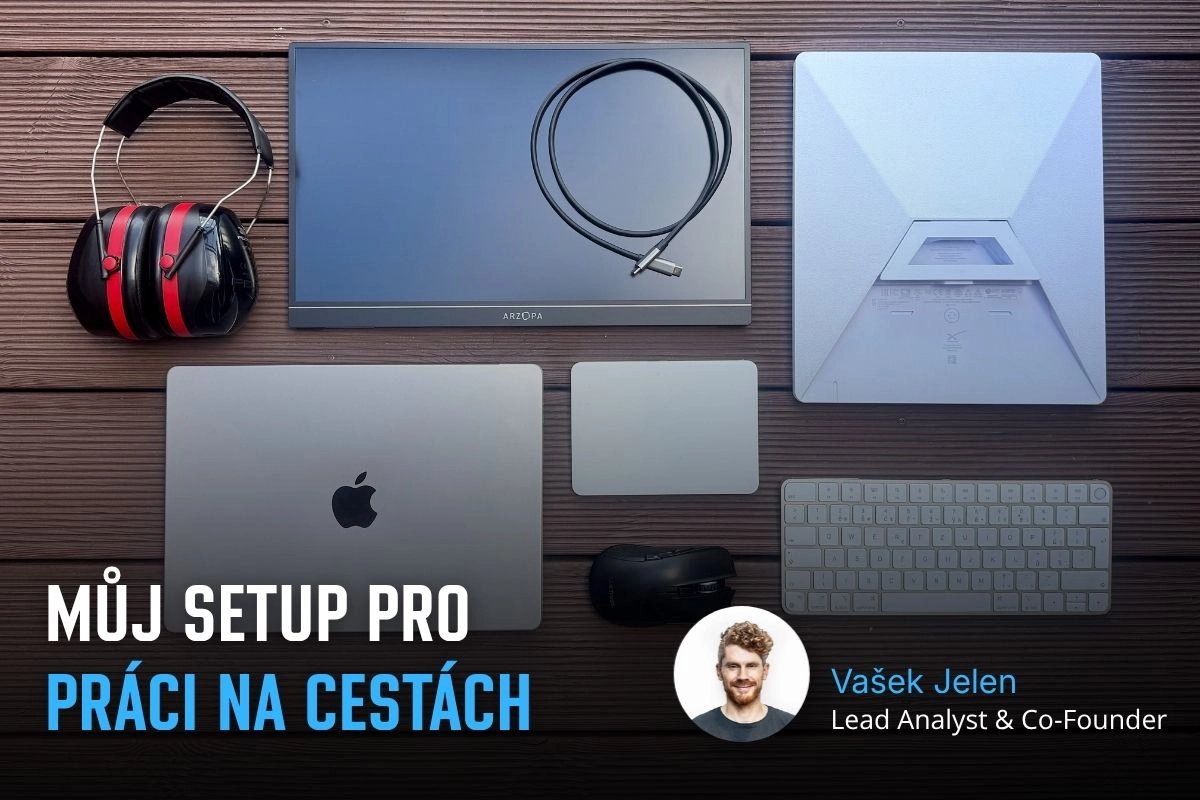
Práce na cestách má svoje výhody, ale taky pár praktických háčků. Sdílím setup, který jsem po několika letech vychytal a který mi umožňuje pohodlně pracovat odkudkoliv – od připojení přes druhý monitor až po ergonomii.
Co všechno by měl PPC specialista vědět o analytice a sběru dat? Na workshopu pro uLab jsme prošli celý řetězec od technických komponent trackingu přes mediální systémy až po sběr a aktivaci first-party dat.
Jak dostat data z reklamních systémů do jednoho warehouse, typicky BigQuery? Projdeme si základní architekturu a rozhodování, než se pustíte do exportů dat z Google Ads, Meta Ads, Skliku a dalších.
Třetí díl seriálu o first-party datech bude opět hodně technický – ukážeme si, jak zkontrolovat, že data správně odcházejí do jednotlivých systémů a dělají to, co mají. Podíváme se na odchozí hity v DevTools i na kontrolu přímo v reklamních platformá
Detailní průvodce sessionizací GA4 BigQuery exportu – od identifikace session a spolehlivého řazení eventů po dva atribuční modely (First Event Available a Session Start), jejich limity a validaci shody mezi nimi.
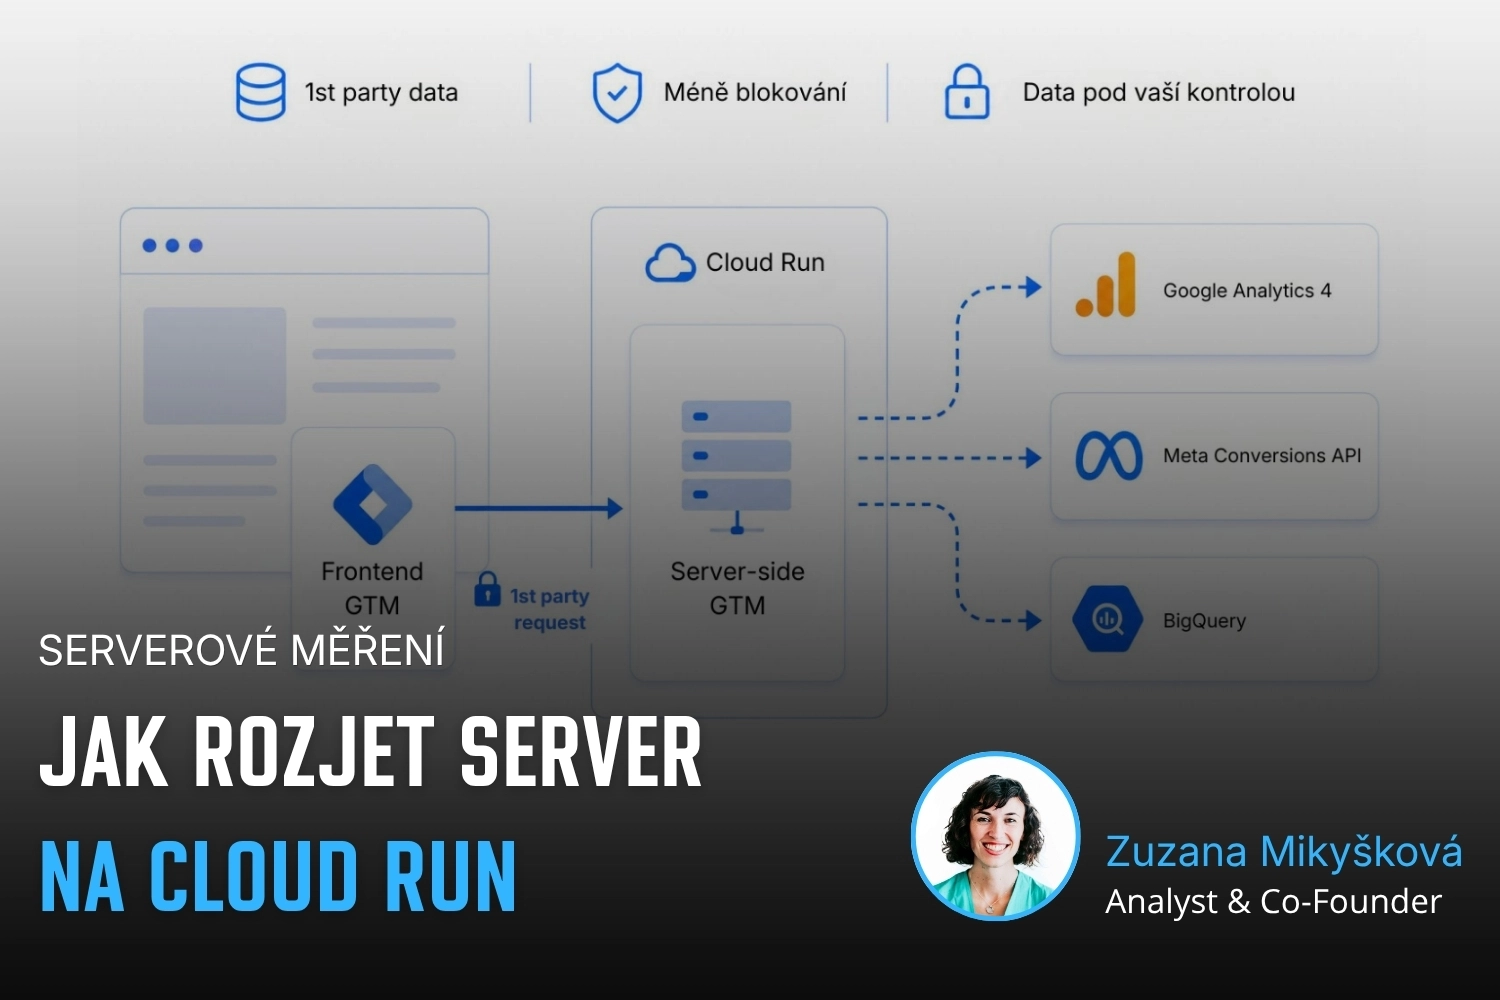
Naučte se, jak nasadit serverový GTM na Cloud Run. Porovnáme Stape s vlastním řešením, vysvětlíme náklady a typy účtování a ukážeme, jak se vyhnout častým chybám při nastavení.
Kompletní technický průvodce sběrem first-party dat přes dataLayer, jejich normalizací, hashováním a odesíláním přes server-side GTM do Google Ads a Meta.
Testovali jsme ClickUp MCP pro management úkolů za pomoci AI. Zjistěte víc o praktických limitech, bezpečnostních omezeních a pro koho se tento nástroj hodí.
Ženy v analytice se často potýkají s imposter syndromem, přestože vynikají v práci s detailem i datovém storytellingu. Přidejte se ke komunitě Data Sisters.
Naučte se, jak přenést historická data z Google Analytics 4 do nového projektu v BigQuery pomocí Data Transfer Service. Podrobný návod krok za krokem se screenshoty.
48 hodin vývoje aplikace s AI na hackathonu #HackYourWeekend v Brně. Od nápadu po nasazení pomocí Claude Code, měření přes BigQuery a získané zkušenosti.
6. 9. se v prostorách Brněnského Gen konal další ročník MeasureCamp - naší oblíbené komunitní akce. Potěšilo nás, že MeasureCampu se letos zúčastnilo 74 žen.
Výpočet dat Velikonoc v BigQuery pomocí algoritmu Computus. SQL skript generuje data Velikonoční neděle, Velkého pátku a Velikonočního pondělí pro analýzu dat z GA4.
Naučte se využívat export Google Ads do BigQuery pro získávání byznysových insightů. Kombinujte jej s daty z GA4 a CRM, řešte atribuční výzvy a zlepšete reporting.
Naučte se pracovat s raw daty z GA4 v BigQuery a Google Cloud Platform. Materiály z workshopu, SQL dotazy a praktické příklady z Marketing Festivalu 2024.
Podívejte se na náš veřejný webinář s praktickými tipy pro vyhodnocování kampaní v GA4 během Black Friday a Vánoc. Naučte se, jak z analytiky v e-commerce vytěžit maximum.
Jana se v MeasureDesign věnuje UX, obsahu a rozvoji webu. Hledá cesty, jak weby zpřehlednit a přiblížit potřebám uživatelů. Pro vlastní klienty je navrhuje i technicky realizuje. V týmu oceňuje spolupráci a společné hledání řešení.
Vojtěch Černý
IT & Data Developer
Vojta se v MeasureDesign věnuje vývoji technických a datových řešení, která mají být nejen funkční, ale i dobře použitelná v praxi. Baví ho propojovat webový vývoj, automatizaci a práci s daty tak, aby věci dávaly smysl jak z pohledu uživatele, tak z pohledu technického fungování na pozadí. Nejvíc ho těší moment, kdy se podaří složit komplexnější problém do čistého a spolehlivého řešení.
Jiří Otipka
Analyst
Jirka pracuje v marketingu přes 10 let a pokud existuje něco, co ho baví více než čísla sama, tak je to jejich propojování. Miluje matematiku a datovou analytiku a protože rád zkoumá i zdrojové kódy, dokáže se hravě domluvit i s programátory jejich jazykem. V MeasureDesign se specializuje na napojování nových datových zdrojů – vytváří vlastní konektory pomocí Pythonu, testuje kvalitu dat a zkoumá, co všeho by se dalo propojit, aby to mělo význam pro business. S Looker Studiem je jako ryba ve vodě a velkou zkušenost má také s vyhodnocováním PPC kampaní.
Lenka Pittnerová
Analyst
Lenka se k MeasureDesign připojila na konci roku 2025 s bohatými zkušenostmi z PPC marketingu, kde dlouhodobě pracovala s Google Ads, Meta Ads a dalšími reklamními systémy. Právě při řízení kampaní ale opakovaně narážela na tentýž problém – špatně nebo nedostatečně nastavenou webovou analytiku, která znemožňovala efektivní optimalizaci. To ji vedlo k tomu, že se analytice začala věnovat nejdřív z nutnosti, postupně však zjistila, že ji baví víc než samotné reklamy. Dnes se zaměřuje především na implementaci webové analytiky a datových řešení, která firmám zajišťují kvalitní a spolehlivá data pro strategické rozhodování i výkonný marketing. Část PPC projektů si ponechává – jednak proto, že ji stále baví, ale hlavně aby zůstala v kontaktu s realitou mediálních systémů a skutečnými potřebami klientů.
Martina Kvasničková
AI & Data Research
Marťa se k MeasureDesign připojila v roce 2025 během studia webových aplikací. Fascinuje ji, jak rychle se vyvíjí svět umělé inteligence, a proto se zaměřila na výzkum velkých jazykových modelů. Ve firmě pomáhá integrovat AI do každodenní práce – tak, aby byla rychlejší, efektivnější a zároveň dostupná pro všechny členy týmu. Nejvíc ji baví hledat způsoby, jak AI využít prakticky a přetavit nové technologie v užitečné nástroje.
Markéta Svěráková
Analyst
Markéta začínala v marketingu, ale pak přišla mateřská – a s ní nekonečný chaos. Potřebovala si zachovat aspoň zbytky zdravého rozumu, a tak se vrhla na data. Čísla totiž nekřičí, nerozsypávají křupíky do klávesnice a dávají aspoň nějaký smysl. V Engeto Academy prošla kurzem datové analytiky, kde se spřátelila se SQL, Power BI, Excelem a Pythonem a začala hledat vzorce i mimo dětské omalovánky. Dnes v MeasureDesign pomáhá klientům zjistit, co jim jejich čísla doopravdy říkají.
Blanka Hejduková
Back Office
Blanka se stala součástí našeho týmu v roce 2024 a od té doby má na starosti oblast back office, včetně fakturace a administrativních úkolů. Využívá své zkušenosti z České pošty a vzdělání v oboru finančního managementu, aby zajistila hladký chod všech procesů. Ve volném čase se věnuje svým dvěma dětem, s nimiž ráda cestuje, a zároveň si užívá práci na zahrádce, kde nachází svůj odpočinek.
Petra Súkeníková
Analyst
Do MeasureDesign nastoupila v roce 2023 a specializovala se na implementaci měření a reporting. Největší radost jí dělá moment, kdy se po všech nastaveních a testech konečně rozběhnou první data. Naopak největší výzvou jsou nečekané (a často nezadokumentované) změny od Google – chvíle, kdy se z analytika stává paranormal behaviour expert. 👻 Byla členkou našeho týmu do léta 2026.
Anna Horáková
Analyst
Anička má více jak 7 let zkušeností z agenturního prostředí, kde spravovala pro klienty reklamní kampaně na sociálních sítích, nejradši pro obsahové weby. Chtěla získat trochu větší pohled nejen na kampaňová data, a tak více směřovala svou práci k webové analytice. K našemu týmu se přidala v roce 2022 a nyní se zaměřuje na datovou analytiku, kde s využitím GA4, BigQuery, Looker Studia a dalších nástrojů může propojovat a analyzovat data ještě víc do hloubky a přinést klientům zajímavé analýzy i podklady pro business rozhodování. Anička byla členkou našeho teamu do roku 2026.
Klára Belzová
Analyst
Klára je ve firmě od roku 2019. Věnuje se hlavně webové analytice, ale nezalekne se ani práce s daty v BigQuery. Nejvíc ji baví, když může klienta provést od definování jeho potřeb přes implementaci měření až k výsledné vizualizaci dat.
Až podezřele velkou radost jí dělá pohled na hezky přehledný GTM kontejner nebo report plný užitečných dat.
Vašek Jelen
Lead Analyst & Co-Founder
Vašek se již více než 15 let věnuje digitální analytice – od nastavování měření po uložení, vizualizaci a interpretaci dat. Firmám pomáhá mít v datech pořádek a umět je naplno využít. Věnuje se primárně datům z digitálních platforem jako jsou weby, aplikace, klientské zóny apod. a propojování těchto dat s dalšími firemními daty jako jsou mediální a zákaznická data. Po letech na volné noze spoluzaložil analytické studio MeasureDesign, kde kromě analytických projektů a školení na míru vzdělává nové analytičky a analytiky.
Zuzana Mikyšková
Analyst & Co-Founder
Zuzčina kariéra vedla přes řízení inovací a výzkumu v korporátu, vedení “wom” (word of mouth) projektů do digitální agentury, kde projektově řídila tvorby webových stránek. Zuzka je ale dost zvědavá a potřebovala vědět, jak web funguje, když je vypuštěn do světa. To ji motivovalo ke studiu webové analytiky, a následně přivedlo k osudové spolupráci s Vaškem a v roce 2019 spolu založili firmu.